语言模型可以继承人类写在互联网上的一切,机器人不行。它的经验没有现成语料库,只能一条一条录下来。
京东集团技术委员会主席曹鹏在今年 9 月给过一组对比:高质量具身数据目前只有数十万小时级别,而行业需要的是超过 1000 万小时。同一个月,Figure 的 Helix 2.5 在 30 套陌生住宅里做家务,零样本任务成功率是 56%。
两个数字指向同一件事:
机器人的身体已经及格,脑子还“不行”。
机器人的“互联网”不存在
LLM(大语言模型)的训练数据可以爬、可以买、可以聚合,因为人类主动把文字和图片放到了网上。但人拧开瓶盖、叠好毛巾、把碗放进沥水架的动作经验,从来没有被系统记录过。这是两条完全不同的数据路径。
具身数据难在三个地方。
- 多模态必须对齐。一条有用的演示要同时包含第一人称视觉、本体感受、夹爪开合甚至触觉,而且都得落在同一条时间轴上。任何一个信号错位,这条数据就废了。
- 动作必须能被还原。光有视频不够,模型需要知道当时末端执行器在空间里的位置和姿态。这也是为什么专业采集设备要装 SLAM,而不是随手拍一段视频。
- 失败样本更值钱。真实作业里信息量最大的是犹豫、纠错和人工接管,而这三样恰好最难被采到。
这也决定了具身数据只能靠人去现场做出来。
路线一:把各家已有的数据集拼起来
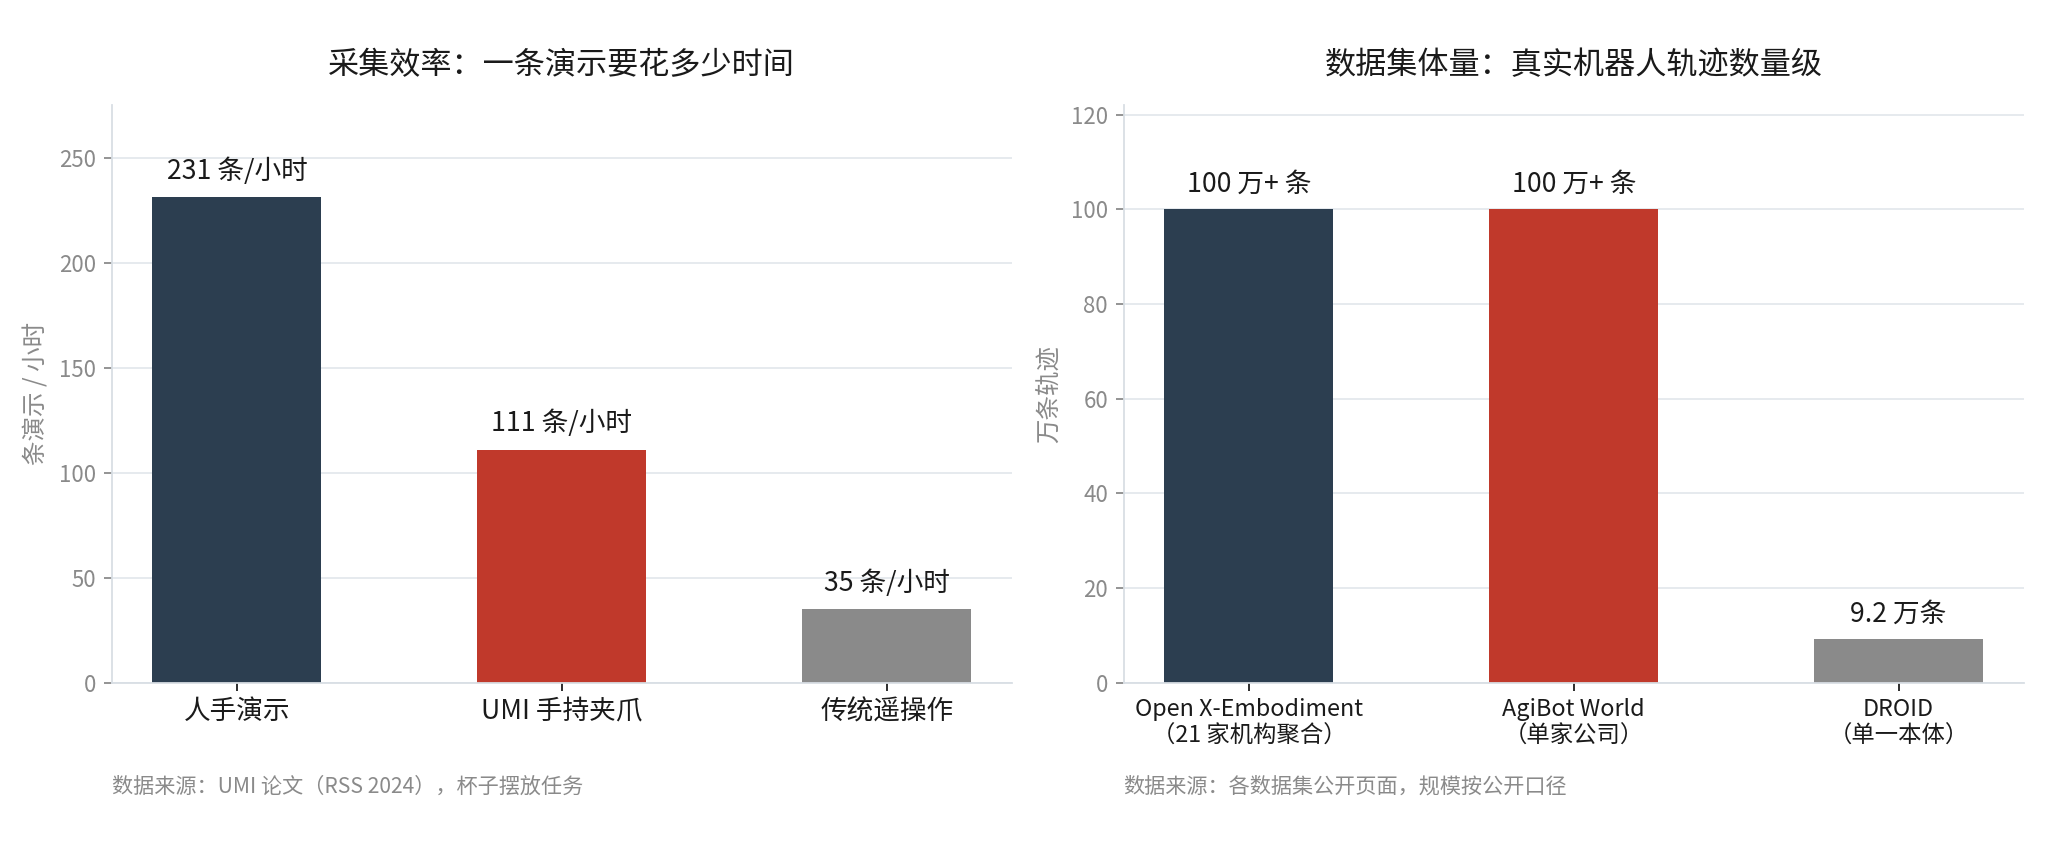
Open X-Embodiment 是 Google DeepMind 联合 21 家机构完成的工作,论文发表在 CoRL 2023。做法是把 60 个已有的机器人数据集统一成同一种格式,再合成一个标准仓库。
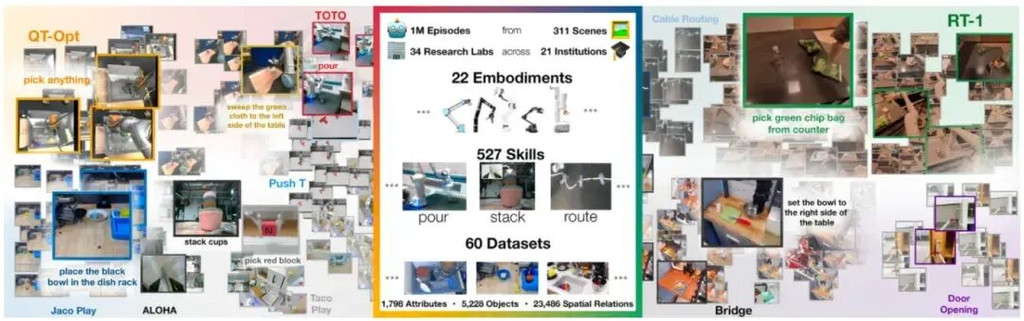
合并之后的体量是:22 种机器人本体、超过 100 万条真实机器人轨迹、527 项技能、160266 个任务,覆盖从单臂到双臂再到四足的各种形态。
比体量更重要的是结论:跨本体迁移成立。用这批混合数据训练出的 RT-1-X 与 RT-2-X,在多个机器人上的表现超过了只在单一机器人数据上训练的原版模型。这等于用实验回答了「多样性到底值不值钱」。
代价是异构。不同实验室用不同相机、不同控制频率、不同动作空间,拼在一起适合做预训练,离直接部署还有距离。
路线二:让所有人用同一套硬件和流程
DROID 选择了相反的思路。与其把不同的数据拼起来,不如从一开始就让所有人用同一套设备采。
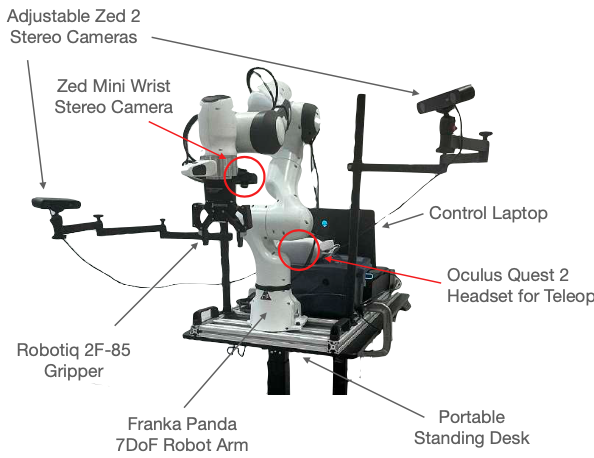
13 家机构使用完全一致的硬件:一台 Franka Panda 七自由度机械臂、两台可调角度的 ZED 2 立体相机、一台腕部 ZED Mini,加上 Oculus Quest 2 头显与手柄做遥操作。全部设备装在一张可调节高度的桌子上,方便快速换场景。
规模上,公开口径约在 7.6 万至 9.2 万条操作轨迹之间,覆盖 564 个真实场景。它的优势是数据一致性远好于聚合方案,相机位置、采集协议、回合格式都是统一的,模型之间可以直接横向比较。
代价是单一本体。换一台机器人就得重新适配,而且采集工作高度集中在少数几家机构手里。
路线三:干脆不要机器人
UMI 由斯坦福、哥伦比亚大学与丰田研究院合作完成,发表在 RSS 2024,拿到当年的最佳系统论文提名。它的硬件简单到有点反直觉:一个 3D 打印的扳机式平行夹爪,加一部 GoPro,就是全部的传感器和记录设备。
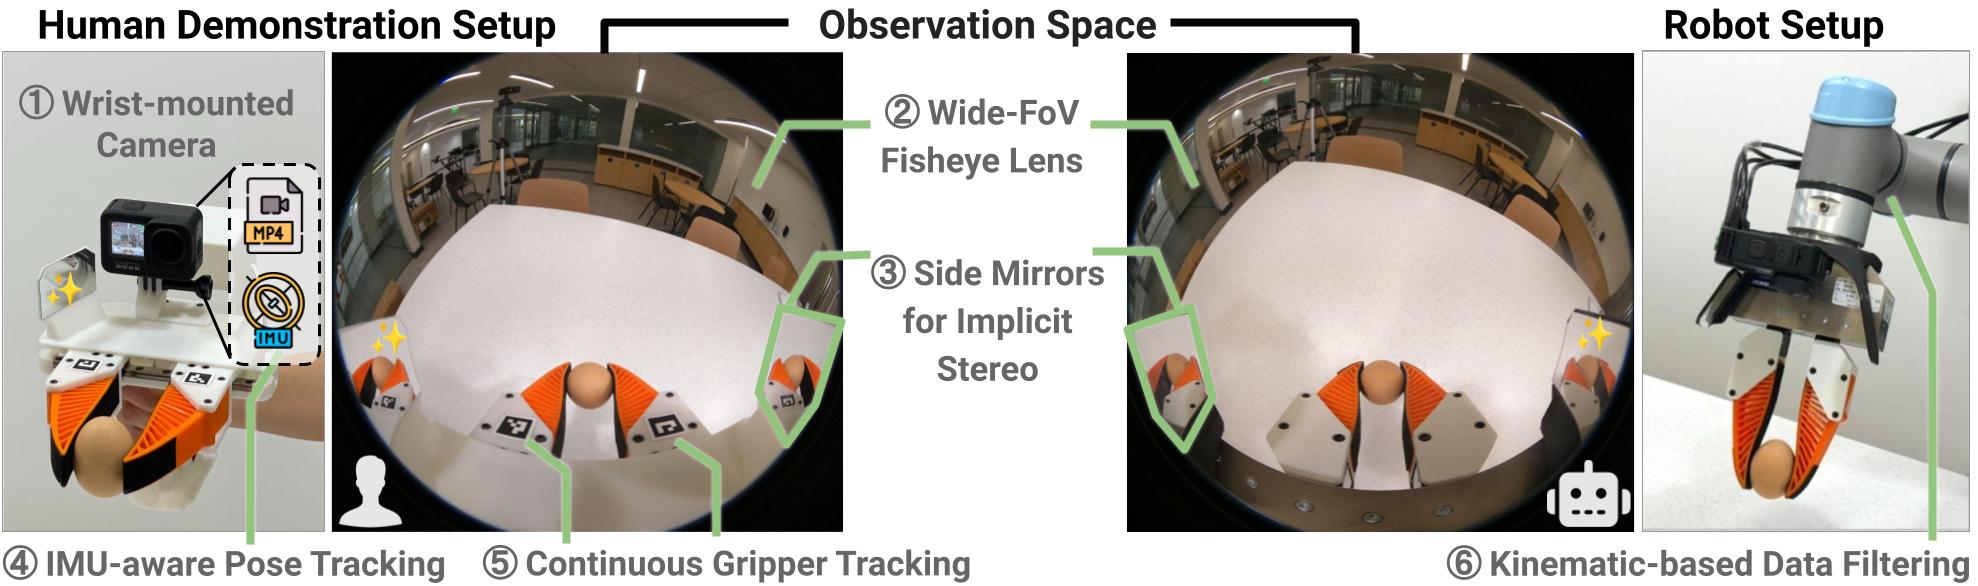
关键在它换回了什么。GoPro 的鱼眼镜头给出腕部视角的第一人称画面,镜头两侧的物理反光镜提供了隐式立体信息。IMU 配合视觉惯性 SLAM,把画面还原成米制尺度下的六自由度末端轨迹。夹爪开合宽度由一条机械连杆直接记录,于是策略学到的是连续开合量,而不是简单的开或关。
采集效率的对比很能说明问题:在杯子摆放任务上,UMI 夹爪每小时能采 111 条演示,传统遥操作是 35 条,人手直接演示是 231 条。
更重要的设计在策略接口这一层。UMI 做了推断时延匹配,并用相对轨迹而不是绝对坐标表示动作,这两件事让同一批数据可以脱离具体的机械臂。这也是它被称为「无本体」的原因。
这条路线后来长出了一整支队伍:DexCap 用手部动捕做灵巧操作数据,FastUMI 把机械结构与传感解耦以提升采集速度,DexUMI 用外骨骼把人的整只手当作采集接口,ActiveUMI 补上了力觉与主动感知。
三条路线放到一起看,各自赌的东西并不一样:一条赌多样性,一条赌一致性,一条赌可负担性。到目前为止,还没有哪一条能同时拿下三样。
谁在做这件事:产学研
这条产业链的分工已经比较清楚。一端是定义方法的实验室,另一端是把方法做成产能的公司。
学术侧,斯坦福 Shuran Song 的实验室是 UMI 与 DexCap 的诞生地,Google DeepMind 是 Open X-Embodiment 的发起方,伯克利、CMU、哥伦比亚大学和丰田研究院都在同一条线上。国内这一支也不弱:上海交通大学卢策吾团队长期做具身基础模型,清华交叉信息研究院走出了星海图的 CEO 高继扬和后来创办破壳机器人的许华哲,北京大学王鹤带出了银河通用,上海人工智能实验室与北京人形机器人创新中心承担的是公共数据与开源平台的角色。
北京人形机器人创新中心的数据基地对外披露过一组产能数字:数据采集有效率提升到 95% 以上,日产能突破 500 小时,年产能达千万条以上,开源数据集的全球下载量超过 600 万次。针对不同本体数据难通用的痛点,他们给出的工具是头戴式采集设备和便携式夹爪。
海外公司里,Figure 的动作最具体。它自建了人类行为数据集 Index,Helix 2.5 正是基于 Index 预训练,让机器人在陌生住宅里完成整理客厅、叠毛巾和铺床,零样本任务成功率从 8% 提升到 56%,任务专用数据只用了一半。Figure 称已向数据创作者支付 1500 万美元,并承诺投入 35 亿美元算力。
国内的玩家密度更高,大致可以分成三类。
一是本体公司自带的模型与数据业务,宇树、星海图、银河通用都在这一类。优势是闭环,机器人卖出去或租出去本身就在产数据,而且自家真机产出的数据在构型上天然匹配自家产品。
二是专业数据服务商,光轮智能、帕西尼、灵初智能、它石智航与智元系的觅蜂科技都属于这一类,数据可以卖给上下游不同客户,身份开放,但单纯卖数据的议价空间有限,这类公司最后大多想往模型层靠。
三是互联网大厂的数采平台,代表是京东,仓储、门店和配送网络本身就是天然采集场,代价是只做采集这一层的价值偏低,更多是配套自家机器人生态。
分享一些值得看的资讯:
- 智元系是这轮动作最密的。旗下觅蜂科技 9 月末上线觅蜂派众包平台,用户租一套头显接任务采集,报酬每小时 10 至 20 元,设备日租 39 元、推广期 19 元。官方称内测一个月注册约 2 万人、累计提交任务 1.3 万份,截至 8 月 31 日无本体有效数据累计达百万小时,第 20000 套 MEgo 设备也在 8 月底下线。
- 帕西尼从触觉传感器起家,8 月发布五指数据采集手套 PXCap Pro,在天津建有 1.2 万平方米的数据采集工厂,9 月与比亚迪合作推进工业具身数据采集与治理。
- 光轮智能在 8 月的世界机器人大会上发布十万小时开源人类数据集 EgoSuite-Open100K,首批数据在 Hugging Face 与 AtomGit 开源。诺亦腾贡献动作捕捉与力反馈采集能力,黎曼动力与这两家的合作目标是 2026 年底完成 100 万小时数据采集。
- 宇树发布 UnifoLM-WLA-1.0,60 亿参数,基于约 2500 小时真机数据训练,单模型可统筹 64 项任务。智元则用 AGILE 2.0 与 GE-Act 2.0 做了一次对照,数据量扩大 100 倍之后,任务能力出现明显跃升。
- 星海图把泛化直接定义成培训成本,目标是把新任务的后训练时间从 10 小时压到 1 小时。银河通用的说法更激进,王鹤称其模型已实现跨本体、跨任务、跨场景操作。
- 京东计划两年内采集超 1000 万小时真实场景视频数据,并在探索家政场景下用头戴设备做第一视角采集。阿里云为具身场景单独做了 PAI 的 EgoX、RoboX、TurboX 三条产品线,覆盖数据处理、模型训练与性能优化。
把无本体数据做成一条流水线
穹彻智能(Noematrix)创始人卢策吾是国内最早研究具身智能的学者之一。它对外强调的是以力为中心的具身基础模型。这家公司把数据这一环拆得很细。采集端是自研的 RoboPocket,一套可穿戴末端执行器加手机 App 的组合,普通人不用接触机器人本体就能参与操作采集,记录里包含纠错与人工接管这类过程。治理端是 DM3 数据管理平台,负责检索、质检与资产管理,报道给出的数字是单日管理近万条数据,每月沉淀约 15000 小时真实数据资产。
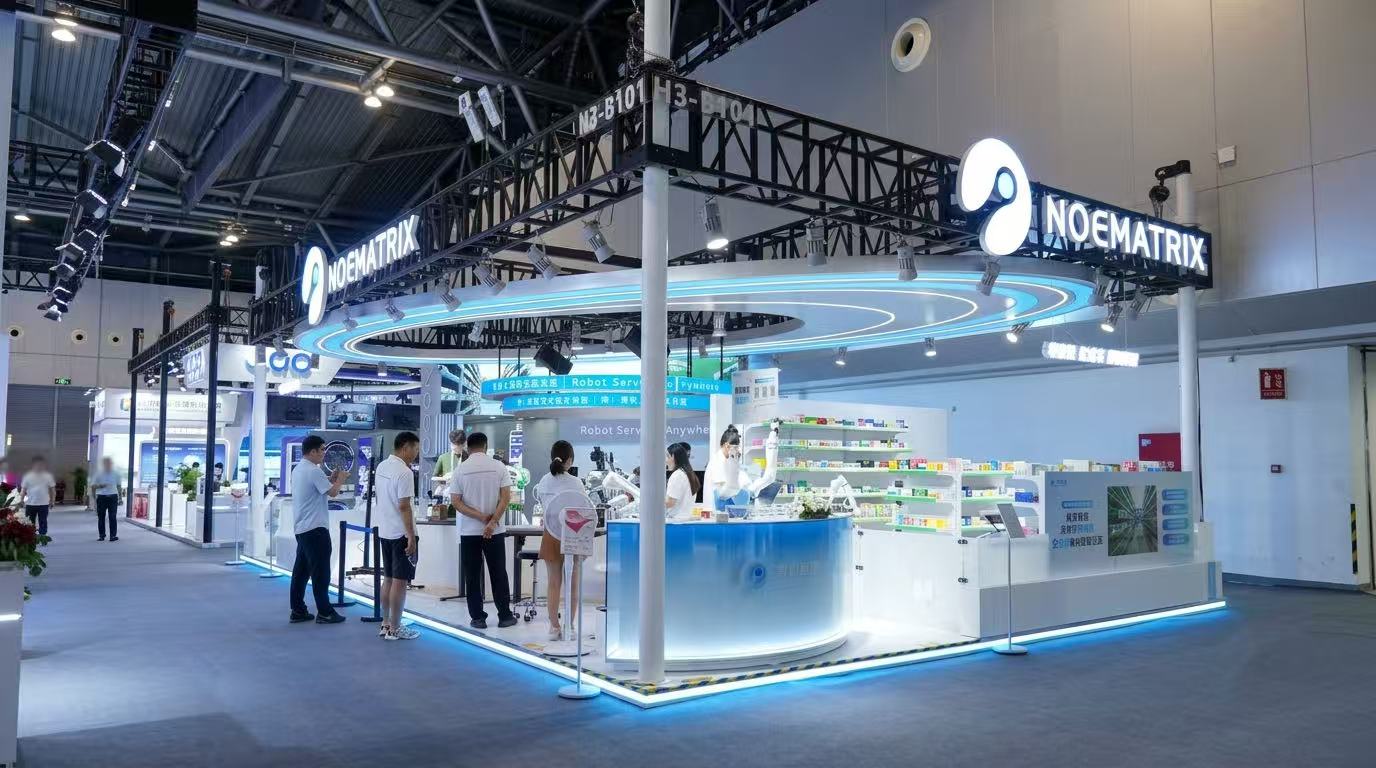
模型端是 2026 年 8 月发布的 Noe-0,采用世界动作模型架构,官方称预训练与后训练全程未使用遥操作数据,采集覆盖 50 多个城市、数十万小时、数十万种任务类型。落地端的选择很务实,药房场景做到 3000 多个 SKU 的识别与抓取,不需要改造原有货架,约 2.5 平方米就能部署,已在沈阳等地的连锁药房完成运行验证。
今年 6 月它完成数亿元融资,投资方包括上海交通大学 AI 未来基金、上海创智学院旗下公司、无锡数据集团与一村资本,更早的股东名单里有 Prosperity7 Ventures、红杉中国、C 资本、阿里巴巴与 Sea Limited。公司与无锡数据集团还一起启动了城市级的“千企百万小时”具身智能高质量数据集联合体行动。
这条路径的价值不在规模,而在于它把采集、治理、训练与真机执行四段接成了一条线。同类路线的公司不少,能把四段都跑通并且拿出落地场景的还不多。
政策层面也在跟进。9 月 10 日,国家数据局召开具身智能座谈会,参会方包括中国科学院自动化研究所、北京通用人工智能研究院、光轮智能、京东、星海图、自变量、北京人形机器人创新中心等,会议提到将适时推动具身智能数据标准建设,并支持企业加大数据投入。
数据采集中心正在变成一门收入
这是国内特有的东西。
中国信通院《具身智能训练场研究报告(2026 年)》给出的数字是,截至今年 6 月底,全国建成启用的具身智能训练场超过 70 家,在建或规划中的还有 40 多家,其中浙江以 14 家居首,江苏、北京、广东、山东各 8 家。
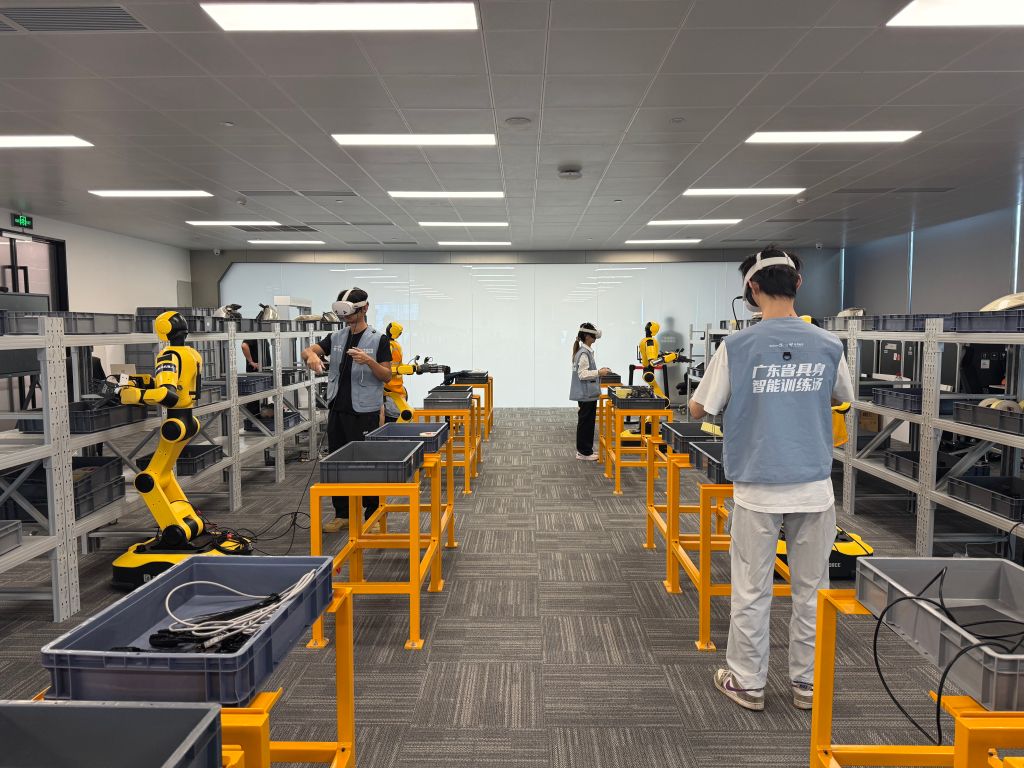
它们的运转方式大致是:地方政府希望拿到前沿产业的政绩和就业,地方国资出资建设数采中心,数采中心向机器人公司采购整机,机器人边采数据边被计为交付,采到的数据再回流给具身智能公司训练模型。
有报道披露,某家估值超过 200 亿元的机器人厂商,2026 年有 500 台机器人来自各地合作数采厂,按 70 万元均价折算,对应约 3.5 亿元营收。也就是说,数据采集在这门生意里同时是成本项和收入项。
争议由此而来。梅卡曼德创始人邵天兰在自家公司上市后公开发文,质疑部分企业利用数采中心和关联交易制造虚假且不可持续的收入,并点了银河通用的名,后者两次回应否认。
同期据外媒报道,证监会通过非正式窗口指导提高了人形机器人企业的 IPO 门槛,重点看营收真实性、盈利稳定性和商业化落地能力。国家发改委在 8 月底也强调过,机器人产业要防止盲目跟风、一哄而上。
这件事的要害不在真假,而在三个追问:
掏钱的是财政还是市场,采来的数据有没有真的让模型变强,今年的收入基数抬上去之后明年拿什么维持。
训练场自身也难独善其身。多数训练场目前以出售数据产品为主要收入来源,仅靠这一项很难覆盖重资产投入,有的已经开始谈“训练即服务”,想把数据生产、模型训练与应用验证打包成服务,做出多元收入结构。这门生意到底是产能还是能力,最后还是要靠真实付费的客户来回答。
众包这条路,走得通吗?
把采集任务分给普通人,这个想法并不新。2016 年,Comma.ai 推出过一款行车记录应用 Chffr,让用户把手机架在挡风玻璃前自动上传驾驶数据,指望攒出海量数据训出自动驾驶模型。十年过去,这家公司没有成为自动驾驶的主角。
招聘信息里,居家叠衣服这类采集任务开的是每小时 30 元,拍满 8 小时,一天大约进账 120 元。但采集时长不等于有效时长,光线不足、手移出画面、动作太快都会被扣帧,8 小时里真正算得上有效的往往不到一半。价格还在往下走:今年 3 月有效时长的众包价是 50 元一小时,到 5 月已经落到 20 到 22 元。有行业人士估算,付给采集者的报酬加上培训、审核、标注和算法处理,数采厂商的总成本约每小时 100 元,对外售价能到 200 元。
具身数据众包,本质上在重复同一个假设:只要量足够大,质量可以靠后处理补上。但有四个地方比以往更难。
- 效率没有想象中高。UMI 的 100+ 条/h 出自受控实验,众包场景还要算进设备发放、任务指导、质检和返工。
- 无效数据的代价更高。有从业者给出的估算是,纯头显的第一视角数据有效率只有 10% 到 20%,重复动作和犹豫还会被模型原样学走。
- 存储成本被长期忽略。约 50 小时数据需要 1.4T 存储空间,数据量上到千万甚至亿级之后,存在哪。
- 泛化没有捷径。宇树创始人王兴兴曾提到,固定场景的训练成功率可以接近 100%,但环境稍有变化,成功率就下降严重。
Figure 的 56% 是这条线上目前最好的公开成绩。伯恩斯坦的评论是,Helix 2.5 跨越的是场景而不是任务,从 56% 走到 99% 才是真正的下一场大考。
值钱的是小时数吗?
把上面的线索合起来,可以给出一个判断:
具身数据不是一种能自由买卖的商品。它的价值与具体的本体、具体的模型、具体的任务深度绑定,同一批数据换一台机器人可能就贬值。这也是数据集交易在这个行业里格外难做的原因。
真正能形成护城河的,不是采了多少小时,而是覆盖了多少种失败。
数采中心可以托住行业的早期阶段,但如果长期依赖财政资金和关联交易,它验证的只是产能,不是能力。
如果要找一个可验证的信号,不该看数据集的总时长,而该看模型在陌生环境里的成功率曲线。