“超级智能实验室成立一年多之后,我们开始发布这个团队做出的东西。”
美东时间 10月12日,Meta 发布了两款新模型:Muse Wonder 和 Muse Wonder Full。内部代号「西瓜」(Watermelon),由首席人工智能官王以恒带队(就是那位用 143 亿美元交易入场的人)。
这是超级智能实验室重组以来的第二代模型,也是 Meta 第一次把“对标 OpenAI 和 Anthropic 顶尖模型”写进官方口径里。
先摆数字。第三方评测机构 Artificial Analysis 的智能指数 v4.3 里,Wonder 拿 52 分,Wonder Full 拿 56 分,排全场第二。
距离 Anthropic 的 Claude Opus 5.5 只差 2 分(对一年前的 Meta 来说,这个差距约等于没有)。
上一代 Muse Spark 1.3 是 48 分,两次发布只隔了 6 周。
100 万 token 上下文,文本、图像、视频、音频都能收(几乎把“个人”两个字焊死在产品定位上);API 定价每百万输入 token 4 美元、输出 20 美元。
真正扎眼的是另一行字:更强一档的 Wonder Full 不上架 API,只向编程工具 Muse Code 的订阅用户开放。
按理说,这是一场值得鼓掌的“翻身仗”。但发布之后,围绕这两个模型的第一个问题不是“强不强”,而是“这次有没有造假”。
网上流传的说法把这事和 Llama 5 扯在一起。可 Llama 5 根本没发布过。真正该被翻出来的旧账,是 Llama 4。
一、Llama 怎么凉的
Llama 曾经是 Meta 最值钱的招牌。2023 到 2024 年,Llama 2 和 Llama 3 是全球开源模型的事实标准。
无数创业公司拿它当底座,“开源旗手”四个字值几百亿市值。
然后是 Llama 4。2025 年 4 月发布,公开榜单上风光了没几天(“风光”这个词都算客气),就被评测机构戳穿:公开基准和保密测试是“两副面孔”。
评测公司 Vals 的联合创始人 Rayan 后来在 a16z 的对谈里把它当反面教材讲:Llama 4 在主要公开 Benchmark 上成绩亮眼,在 Vals 的保密测试集里却低于预期。
这事坏在哪?坏在它把“榜单”这门生意的底裤掀了。试题公开、评分标准公开,模型就可以对着考纲刷题;分数和真实能力之间,隔着一道可以优化的缝。
从此业内谈起 Meta 模型,默认句式变成“官方数据仅供参考”。
更深的伤口在人。超级智能实验室重组时,Meta 用 143 亿美元换来了 Scale AI 的股份和王以恒。
又开出超过 2 亿美元的薪酬包从苹果挖走基础模型负责人(这个数字比很多上市公司一整年的研发预算都高)。
Llama 线的核心成员在 2025 年陆续离开,此后再没有 Llama 5 的官方消息。
一个可以参考的细节:到今年 9 月,亚马逊 AWS Bedrock 的模型货架上,Meta 系列的最新款还是 Llama 4(货架上同时躺着的还有 OpenAI、Anthropic、谷歌和一票中国模型)。
顺带说一句公道话,“大厂刷榜”不是 Meta 一家的毛病。9 月初 OpenAI 发布 GPT-6 Astra,公告里的基准数据被 Fortune 抓包改了好几轮,自家成绩上调、对手成绩下调。榜单的水分,是行业性的。
但第一个把公众信任刷没的,确实是 Meta。
二、先有 App,后补心脏
为什么突然冒出来一个 Muse?我先把结论放在这:它不是从模型线长出来的,是从应用线长出来的,顺序和别家正好相反。
时间线倒着捋。9 月 8 日,Meta 发布个人智能体应用 Muse,22 天拿下 500 万下载。
连续 12 天霸榜美国 App Store 免费榜,比 ChatGPT 当年快了一倍多。
10 月初,Muse 宣布登陆智能眼镜平台,底层是云端常驻的 Linux 虚拟机,用户关掉应用,它还在替你跑任务(苹果都得为它改系统权限,能量可想而知)。
小扎的口径是,要让数十亿人用上“个人超级智能”。
王以恒最近上了档播客,给这个顺序补了个注脚:行业都在押编程 Agent,他押的是个人 Agent,理由是 Meta 在覆盖“人类欲望”上有独家优势。
Muse 团队为此建了一张一百多项行为能力的检查表,追求“绝大多数情况下都很好”,而不是“偶尔惊艳一下”。
支撑这个 App 的,是 9 月第一周发布的 Muse Spark 1.3,超级智能实验室的第一个模型家族。
那批发布有多挤?72 小时之内,Anthropic 的 Claude Fable 5.1、谷歌的 Gemini 3.8 Flash、Meta 的 Spark 1.3、OpenAI 的 GPT-6 Astra 接连亮相。
Spark 1.3 在 Artificial Analysis 智能指数上拿 48 分,与 GPT-5.6 Sol、Grok 4.6 打平。
单个任务成本约 0.55 美元,还开了个“贡献版”白菜价 API 换开发者反馈。
所以故事的顺序是:Meta 先把 500 万用户的壳造好,再回头给它“换心脏”。「西瓜」就是那颗心脏。
扎克伯格在 X 上把话说得很明白,这是实验室成立一年多来团队做出的第一批成果。言下之意:Spark 1.3 只是“热身”,“交作业”的是「西瓜」。
这 14 个月 Meta 花了多少钱?资本开支从 2024 年的 390 亿美元涨到 2025 年的 722 亿,2026 年的指引是 1300 亿到 1450 亿。
但人不多:小扎自己透露,核心研发团队只有约 100 人(烧的是钱,不是人头)。
长期债务从 288 亿涨到 837 亿(三年前这个数字只会出现在财报脚注里)。据 IT 之家报道,今年 7 月 Meta 还暂停过一次模型预训练(自家的团队踩下自家的刹车,这事本身就够写一条),直接把「西瓜」的发布拖到了 10 月。
彭博社把这次发布称作“对重建后超级智能团队的检验”,话讲得很客气,潜台词是:花成这样,总得拿点东西出来。
三、几斤几两
先说强的地方。Artificial Analysis 是第三方,不是 Meta 自己拉表。它给 Wonder Full 56 分,全场第二(Opus 5.5 是 58 分),和 Claude Sonnet 5.5 打平;Wonder 52 分,同在前三。
从 48 到 56,六周涨 8 分。
Meta 官方的口径更激进:在 14 项公开基准里,Wonder Full 有 8 项超过 Opus 5.5。两个最能体现定位的长任务基准,SWE-Marathon 拿 57.5 分,Opus 5.5 只有 46.3,差了 11 分。
DeepSWE 拿 79.0%,压过 GPT-6 Astra 的 74.1%、Opus 5.5 的 74.2%,也压过 Claude Fable 5.1。
SWE-Marathon 值得多说一句(这是“西瓜”含金量的核心证据):它要求智能体在 2 到 10 小时里独立完成整个软件项目,中途自己规划、自己调工具、自己从错误里爬出来。
这正是「西瓜」和聊天机器人的分野:它卖的不是“答题”,是“连续干活”。跨对话记忆(Active Memory)加长时任务(Active Focus),Muse 应用那 500 万用户等的就是这个。
再说虚的地方。王以恒自己承认,编程能力还不如 Opus 5.5(自家旗舰发布当天自曝短板),“团队正在排查 bug”。
开发者实测里,它生成 3D 场景明显逊色于 Opus 5.5,连 Meta 自己都承认视觉与空间推理是“已知局限”。响应速度倒是有好评。
第三方评测还给出了一排“没追上”的清单:计算机操作、从零构建程序这类测试,它仍落后于 Opus 5.5。
安全方面,上代 Spark 1.3 在谷歌 Gemini 4 发布时的安全测试里,提示注入破解成功率 15.9%,对照 Claude 的 1%、Astra 的 8.5%,属于“差生”区间(好在「西瓜」还没人测,悬念留给下一场)。
独立实测呢?还没出分。Agent Arena 上线了 Muse Wonder 系列,截至 13 日晚,评分还是“即将公布”,流出的只有第三方开发者的实测视频(3D 场景、动画 HTML、前端设计,挨个和 Astra、Opus 5.5 打擂台那种)。
发布当天拿不出独立人评,不是 Meta 一家的问题,是整个行业的发布姿势。现在为「西瓜」下任何结论,证据都不齐。
四、造假疑云
回到那个绕不开的问题:这次的跑分,是不是又刷出来的?
我的做法是把能查到的证据摆成一排,再下判断。
- 一是第三方独立机构测了。Artificial Analysis 自购算力、统一流程,56 分、全场第二。如果「西瓜」是 Llama 4 式的注水货,这一关过不去。
- 二是官方口径有收敛痕迹。Meta 自己承认编程不如 Opus 5.5,官方基准图也没敢全绿。真正拿下“SOTA”的项,集中在自家定义的长任务基准上:和公司愿景同名的 Personal Superintelligence Index,配套“主动专注”发布的 FocusBench,连 SWE-Marathon 的出题人也是 Meta 自己。评测项自己起名、自己算分(既当运动员又当裁判,这题怎么出、怎么判都是自家说了算),说服力天然打折。
- 三是独立人评缺席。Agent Arena 分数截至发稿未出,早期口碑两极,夸和骂都先攒着。
- 四是行业背景添了乱。Astra 9 月被 Fortune 抓包改数据,Harvey 和 Artificial Analysis 上月搞了“幻觉门控”评分——要求通过测试的交付物不得含重大事实错误,结果超过六成的“通过”答卷里都有大幻觉。连第三方基准都在防作弊,用户对官方口径什么态度,可想而知。
我的判断:这次没抓到造假。但这份成绩单的可信度结构很别扭:独立机构背书了“模型确实是前沿级”,而“哪些项超 Opus”主要靠 Meta 自选自评。
这和造假是两回事:造假是伪造数据,这次更像是“选择性出题”。
真正值得记下的是另一件事:Llama 4 之后,行业对 Meta 的默认预期被调到了最严档,任何不规范都会被按上次的罪名“预审”一遍。这份警惕不是公众多疑,是 Meta 自己欠的债。
五、价格
这次发布里最容易被略过、但分量最重的一行字:Wonder Full 不上 API,只给 Muse Code 订阅用户。
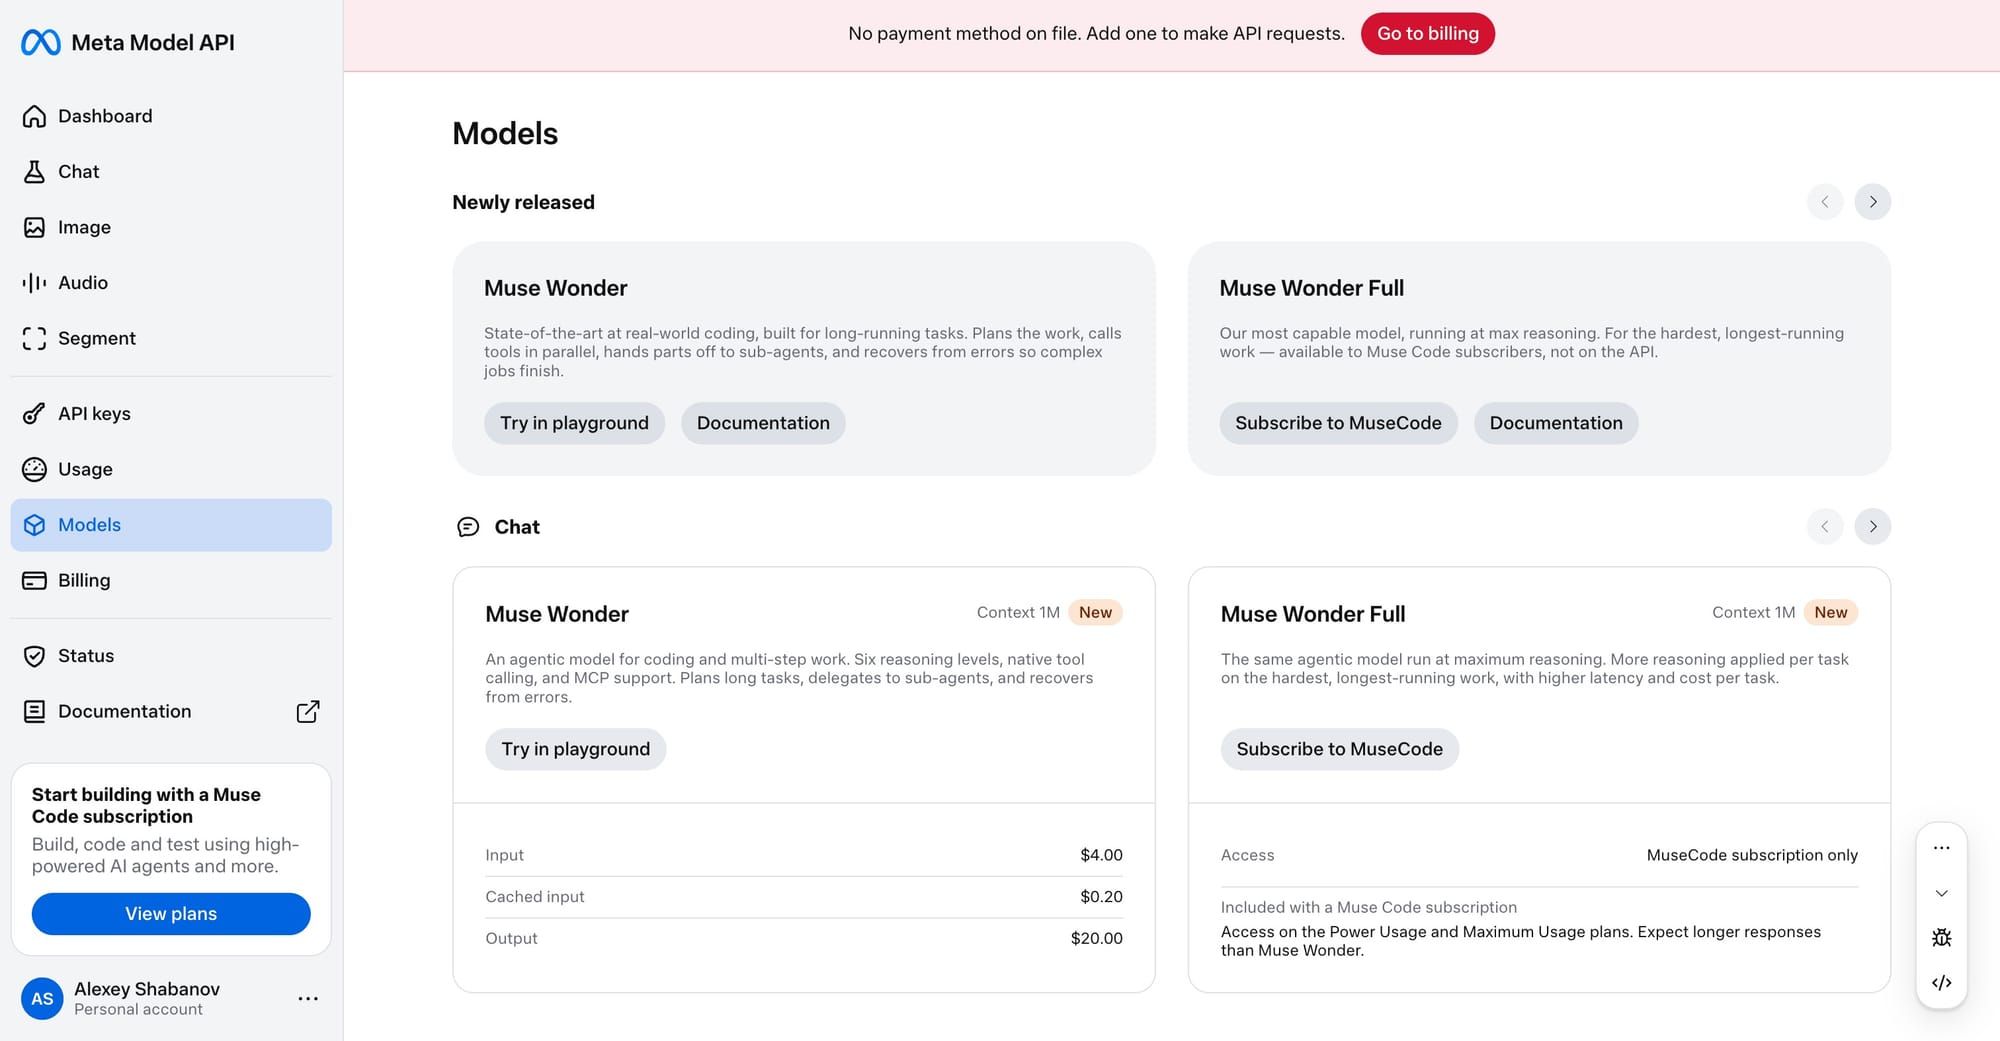
Meta Model API 的定价是输入每百万 token 4 美元、输出 20 美元,缓存输入 0.2 美元(对 Agent 这门生意这项很关键:长任务要反复读上下文,缓存能省一大截),在一线模型里不算贵。
但 Full 版被锁进订阅墙,等于 Meta 第一次把“最强模型”和“付费身份”焊在了一起(发布首日订阅额度还算错了账,王以恒说已经修复)。
因为推理成本先涨了。第三方测算,「西瓜」的平均任务成本从上一代的 1.60 美元涨到 4.52 美元,涨幅 183%。
为什么现在收钱?看账单。2026 年资本开支指引 1300 亿到 1450 亿美元,长期债务 837 亿,外加 143 亿美元的 Scale AI 交易和 2 亿美元一人的挖角包。
CNBC 说得直白:这是在检验用户的付费意愿。
模型强不强是技术问题,用户掏不掏钱是生死问题。
Muse 应用 22 天拿 500 万下载,靠的是免费和新鲜感。发布六个星期后,到了“把流量折现”的段落。
上一篇文章里那笔账还没结:Muse 为了替用户订机票、发邮件,要拿到住址、联系人和支付通道,苹果已经为此收紧了 macOS 权限。隐私的账单没还清,「西瓜」又递来一张新的:“订阅费”。
六、跟我们有什么关系
几条实在的。
对普通用户:又多一个能“干长活”的 AI 助手选项。连续几小时跑任务、跨对话记住你(前提是它别把你的住址发给陌生人),这两样恰好是聊天机器人最缺的。
Muse 应用免费,可以先用起来;要不要为 Muse Code 付费,建议等 Agent Arena 的独立分数出来再决定(截至发稿还没出)。反正它“跑不了”。
对开发者:前沿能力还在降价。4 美元的百万输入 token,摆在两年前是天方夜谭,现在它是对一线模型的“报价单”。
不过任务级成本涨了 183%(单任务均价从 1.60 美元到 4.52 美元),用量大的项目得先算自己的账。
国内这边,字节的项目代号 Spell 在加速推进,腾讯一口气盘点了四款 Muse 类产品(“追赶”这个词是 IT 之家的,我觉得准确)。追赶已经开始。
Meta 用一年半追平了前沿,但中国用户大概率还是先在国产模型上体验到这些能力:生态那道墙,上篇稿子写过,这里不展开。
对 Meta 自己:「西瓜」把 Llama 4 欠下的债还了一半。跑分追上了,第三方背书拿到了,剩下的一半叫信任,得靠一次不缩水的独立实测和一季不跳水的财报来还。
模型的账可以四五周结一次,信任的账,14 个月都不够。