大模型能力上限由模型决定,规模化服务的成本取决于推理框架的效率。
10 月 17 日,DeepSeek 把旗舰更新为「V4.1 Flash 1017」;10 月 19 日,MiniMax 发布「M3.1 Flash」。一周之内,两家头部国产厂商的新作,名字里是同一个词:Flash。
这个词不是国产发明,Google 在 Gemini 系列里用它命名轻量档。但过去它只是别家产品线里的一个后缀,现在成了国产阵营的集体动作。
千问的 Flash 档能塞进 27.6GB 内存的家用电脑,还能在达摩院的玄铁 C950 芯片上,以每秒 43 个 token 的速度出字。
国产大模型进入了“全民过日子”的时代。下游精打细算,甲方开始按“一个任务多少钱”算账,不再为榜单名次付溢价。Flash 不是一个型号名,是一种经营策略:把便宜,做成核心竞争力。
为什么是 Flash?账怎么算?谁在受益?往下看。
一、都叫 Flash
先看 DeepSeek。10 月 17 日的「V4.1 Flash 1017」,在软件工程基准 DeepSWE v1.1 上把成绩从 74.2% 提到 77.0%,API 价格一分没涨,还顺手开放了搜索和抓取接口。
第三方评价不低。Artificial Analysis 的智能指数里它拿 45 分,比上一版高出 6 分,和 GLM-5.3 并列开源权重第二,排在前面的只剩小米的 MiMo-V2.6-Pro。
Arena 的 WebDev 代码榜上,它的 Max 档以 1670 分成为排名最高的开源模型,距离闭源的 GPT-6 Sol 只差 12 分。
但真正的看点在价格栏。省钱省到什么程度?
券商转述的第三方测评显示,它跑完一个完整任务平均花费 0.045 美元,比 GPT-5.6 Sol 中档位低 77.7%,忙时闲时分档定价,闲时再打折。
MiniMax 那边,故事更曲折。
「M3.1 Flash」的预览版在 OpenRouter 上顶着匿名代号「Space Bunny」悄悄卖了两个多月,处理了超过 200T token(日消耗 3.99 万亿),没人知道它是谁。
10 月 19 日,MiniMax 认领代号,正式发布「M3.1 Flash」。这是它沉寂四个多月后的第一款新文本模型。
成绩单不虚:Automation-Bench 拿 62.8%,压过 DeepSeek 的 60.5% 和 Claude Opus 5 的 50.3%;DeepSWE 73.7%,紧咬 DeepSeek 的 77.0%。
Agent 场景的两项硬指标更突出:OSWorld V2 拿 61.7,Agents’ Last Exam 拿 29.6,都排国产第一。
价格是重点。每百万 token 输入 1 元、输出 4 元、缓存读取 0.1 元,比上一代便宜一半还多。
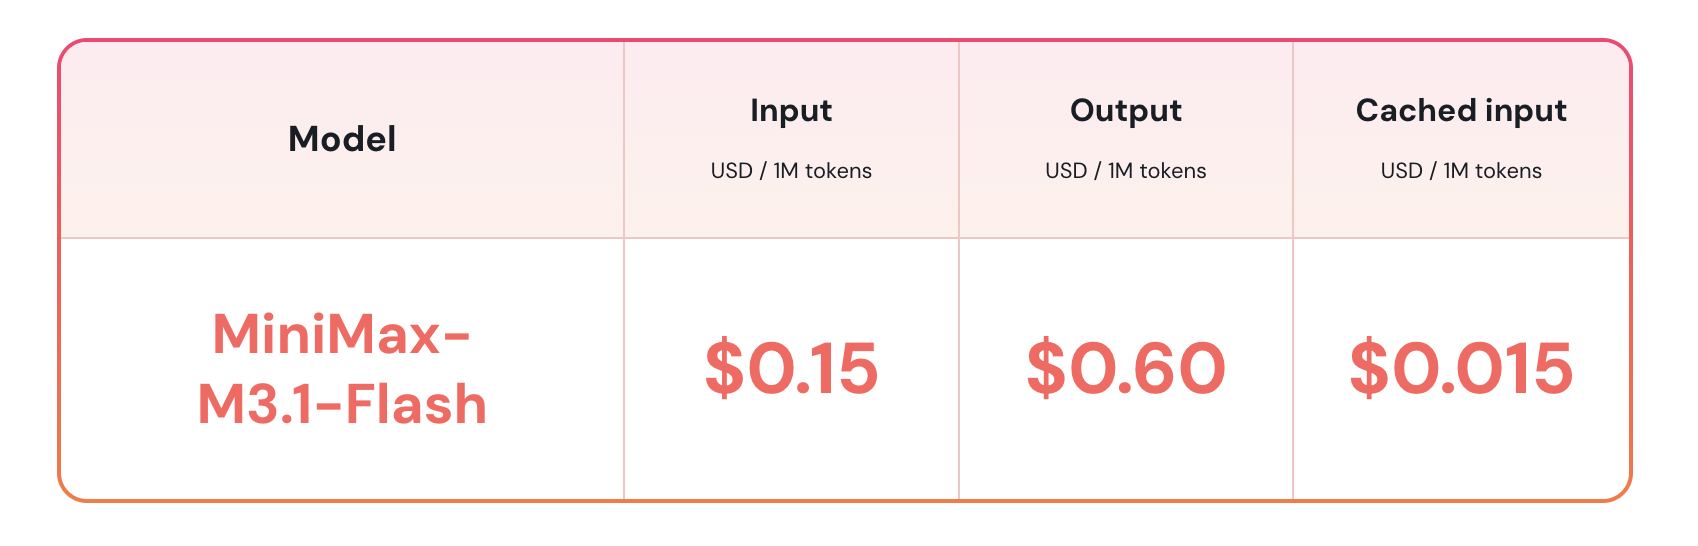
这个价格,约为 DeepSeek 忙时价的一半,和闲时价持平。
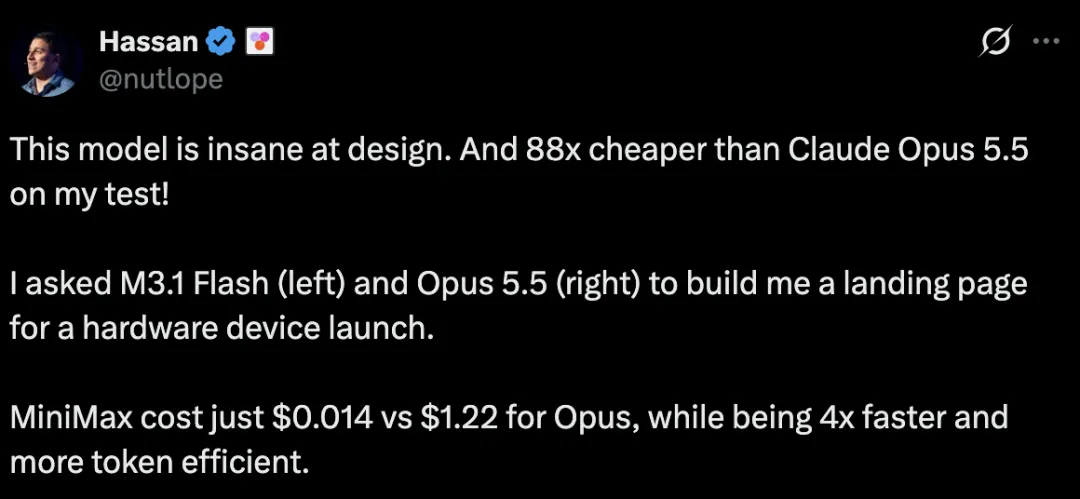
InfoQ 按美元牌价折算,说它比 Claude Opus 5.5 便宜 88 倍。便宜得没有悬念,便宜到有点狠。
配置也不含糊:输出速度中位数每秒 170+ token,上下文 100 万,推理强度分五档,权重稍后开放。
二、谁打榜,谁干活
Flash 到底是什么?表面看是个命名后缀,实际看是一次分工。
翻开 Arena 第 42 周的榜单:kimi-k3-max 排 16,qwen3.8-max 排 22,mimo-v2.6-pro 排 26,glm-5.3-max 排 27。
榜首 gemini-4-argon-high 拿 1525 分蝉联。各家挂出来打排名的,全是 Max 档。
真正在市场上跑量的,是 Flash 档。Space Bunny 两个多月悄悄卖出的 200T token 就是证据:用户嘴上关心谁“最聪明”,钱包投给谁“最划算”。
便宜不是喊出来的,是算出来的。10 月 20 日,DeepSeek 把内部推理框架「DeepInfer」全部开源,连配套的 token 编解码组件一起交出去,英伟达和华为昇腾两套平台都能跑。
开源公告里附了张很直白的账单:V4.1 Flash 的推理服务跑在 DeepInfer 上,单集群日吞吐 155 万亿 token,按谷价计算每卡每小时收入 38 美元(约合 253.81 元)。
彭博社的定性是:这能帮企业把 AI 运营成本打下来。DeepSeek 在知乎同步发的技术报告里,从负载均衡写到 KVCache 留存,把省钱写成了工程学科。
这张名单还能拉长。第三方对 Space Bunny 的评测,对比对象就是 DeepSeek V4.1 Flash 和智谱的 GLM 5.3 Flash;蚂蚁百灵系列里挂着 Ling-3.1-flash。
Flash 已经不是某家的产品决策,是行业的默认命名。
把自家成本方法论白送出去,等于把推理工程的门槛拆给全行业。
护城河挪了位置:从“模型有多聪明”,挪到“单位 token 成本有多低”。
价格下沉的不止模型。DeepSeek 上周开放网页搜索 API,单次 0.005 元,一千次 5 元;同类能力,智谱标价每千次 10 元到 30 元。
模型降价,配套工具跟着降。整条供应链都在换标价牌。
三、一个任务三毛钱
为什么偏偏是现在?答案在 Agent 身上。
聊天时代,一个提问一次调用,token 花不了几个钱。Agent 不一样:帮你订一张机票,要查航班、比价格、填信息、再确认,每一步都是一次调用,每次都拖着长长的上下文。
一个任务几十上百次调用,token 消耗比聊天高一两个数量级。跑这种负载,模型单价就是成本大头。
拿旗舰 Max 档跑 Agent,等于拿跑车“送外卖”,油钱比跑腿费贵。Flash 档就是为这个场景造的:快,便宜,够用。
所以报价方式都变了。DeepSeek 按任务算账,0.045 美元跑一个完整任务,按 7.1 的汇率折算约三毛二(推算)。
MiniMax 的官方口径里,单个 Agent 任务成本最低不到 2 毛。两家都在用同一个单位说话:一个任务。
以前按“百万 token 多少钱”报价,现在直接按“活儿多少钱一件”报价。买东西的人听得懂这种报价。
五档推理强度是同一个逻辑:想让模型“多想”就多花钱,想“省钱”就让它少想,算力定价权交给客户。
只有国产在卷便宜吗?不是。美国的 Inception 把扩散模型「Mercury 3」挂上 OpenRouter,每秒生成超过 1000 个 token,输入输出分别只要 0.10 和 0.35 美元,上线直接五折。
便宜和快,是全球共识。区别在战略位置:美国厂商把性价比当产品线里的一个档位,国产厂商把性价比当主战场。2023 年卷参数,2025 年卷 Agent 分数,2026 年卷“单位成本能干多少活”。
四、市场用脚投票
有意思的是,市场对这个“便宜”故事的第一反应,是抛股票。
财新报道,MiniMax 发布当天股价走高后回落,盘中一度触及 168.3 港元,创上市以来最低。
同一天港股大模型板块整体走低,MiniMax 跌超 6%,智谱跌超 5%,股价跌破 500 港元。
降价难道不是好事吗?对买模型的人是,对持股人是另一回事:单价收入下移,毛利承压。公司上市之后每季度都要拿财报说话,价格战是拿自己的股价打的。
多头也有说法。中信建投的研究意见认为,国产模型能力、调用成本和工具配套同步改善,会推动企业工作流应用和推理需求增长。
翻译过来:单价降了,用量会涨,总账未必难看。
DeepSeek 敢把吞吐和毛利摆出来,是同一个意思:成本领先者不怕降价,怕的是没人用。价格战对它是“清场”,对腰部厂商是“消耗”。
所以有人绕开正面战场。智谱这周发布的是法律专用模型,阶跃披露的是长程 Agent 训练方案,都在找侧翼阵地。
这一轮价格战里,财报好不好看,取决于推理成本能不能继续往下压。能把便宜做进工程里的公司,才熬得起这个周期。
五、便宜之后
三条实在的。
一是对开发者,门槛实打实降了。早两年,旗舰模型的百万 token 还要几十块钱,做 Agent 是“烧钱游戏”;现在一个任务三毛钱,搜索一千次 5 元。
很多原先“算不过账”的点子,现在算得过了。门槛降的不是一点,是一个数量级。
二是对普通用户。你不调 API,但你用的每个免费 AI 功能背后都是 token 账单。Flash 档便宜到可以“随便用”,厂商才敢把 Agent 塞进免费产品。
你明年用到的国产 AI 新功能,多半不是新旗舰的功劳,而是 Flash 便宜到“可以浪费”了。
三是对行业。Meta 10 月中开放权重的「Muse Spark Open」,自称美国最强开放权重模型。
在 Artificial Analysis 的开放权重榜上,它拿 39 分,比 MiMo-V2.6-Pro 的 46 分、GLM-5.3 的 45 分都低,连蚂蚁百灵的 Ling-3.1-flash 都排在它前面。
美国卷“最聪明”,中国卷“最划算”,两条路线正在分叉。分叉不是坏事,各打各的主场。
全民过日子时代,谁也躲不开“性价比”,大模型也一样。榜单是面子,单价是里子。
面子可以吵,里子骗不了人:能把便宜做进工程里的公司,才配在下一个周期谈聪明。